

swanlab.Histogram
python
Histogram(
    sequence: Union[Sequence[float], np.ndarray, torch.Tensor, Histogram] = None,
    bins: Union[int, Sequence[float]] = None,
    *,
    np_histogram: Tuple[Sequence[int], Sequence[float]] = None,
) -> None
np_histogram 为关键字参数。
| 参数 | 描述 |
|---|---|
sequence | 原始样本数据,支持一维数值序列(如 list、tuple、range、NumPy 数组、PyTorch Tensor)或已有的 Histogram 实例。未传 np_histogram 时必填。 |
bins | 分桶数量(1–512 的整数)或自定义桶边界(一维数值序列)。为 None 时默认划分为 64 个等宽桶。兼容 num_bins 参数别名(仅在未传 bins 时生效)。 |
np_histogram | 预分桶结果 (counts, bin_edges),可直接传入 numpy.histogram() 的返回值。传入后忽略 sequence 和 bins。 |
简介
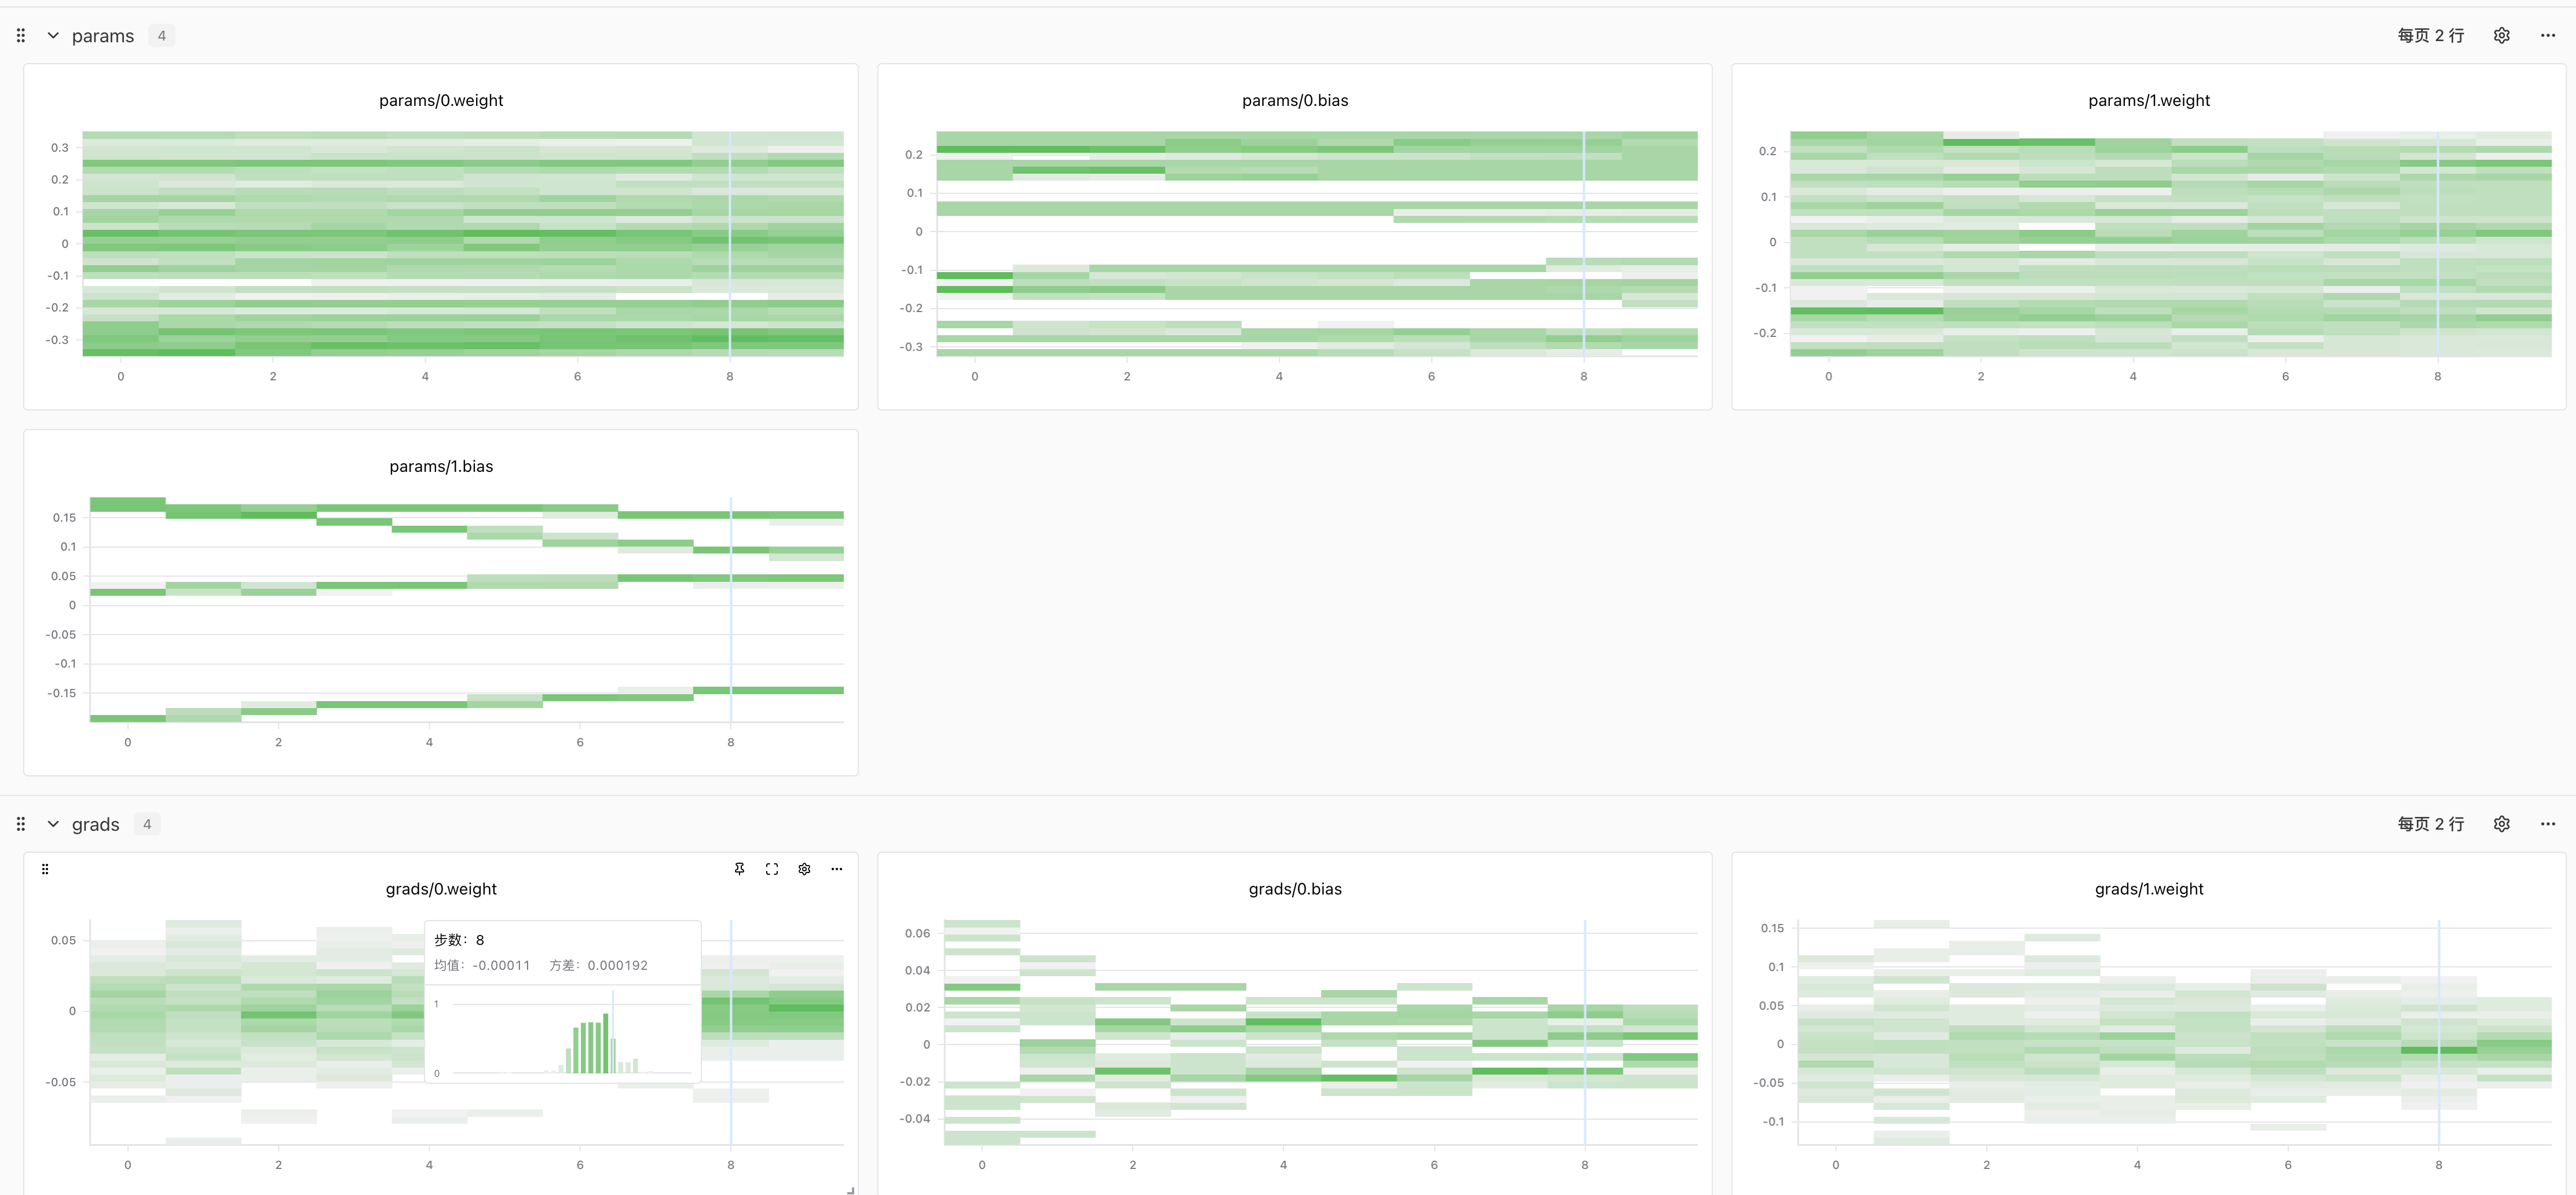
swanlab.Histogram 用于将一组数据转换为直方图,配合 swanlab.log 记录每个 step 的数据分布(如模型权重、梯度等):
- 从原始数据创建:按指定桶数自动等宽分桶,或传入自定义桶边界
- 从预分桶结果创建:直接复用
numpy.histogram()的计算结果
从原始数据创建
传入整数 bins(或不传,默认 64)时,会根据当前样本的最小/最大值自动划分等宽桶:
python
import numpy as np
import swanlab

run = swanlab.init(project="histogram-demo")

rng = np.random.default_rng(42)
for step in range(10):
    samples = rng.normal(loc=step * 0.1, size=1000)
    run.log({"weights": swanlab.Histogram(samples, bins=64)}, step=step)

run.finish()
每次构造 Histogram 都会按当次样本范围独立计算桶边界。样本中的 NaN、Inf 会自动过滤并给出告警;如果过滤后没有有效数值,会抛出 ValueError。
自定义桶边界
如需固定各个 step 的桶边界或使用非等宽分桶,可给 bins 传入边界序列(N 个桶需要 N+1 个递增边界值):
python
import swanlab

run = swanlab.init(project="histogram-demo")

hist = swanlab.Histogram(
    [0.0, 0.5, 1.0, 2.0, 3.0],
    bins=[0.0, 1.0, 3.0],
)

print(hist.values)  # [2, 3]
print(hist.bins)    # [0.0, 1.0, 3.0]

run.log({"weights": hist}, step=0)
run.finish()
除最后一个桶为闭区间 [bins[-2], bins[-1]] 外,其余桶均为左闭右开 [bins[i], bins[i+1])。超出边界范围的样本会被忽略并给出告警。
从预分桶结果创建
如果已经通过 numpy.histogram() 计算好分桶,可通过 np_histogram 直接传入 (counts, bin_edges):
python
import numpy as np
import swanlab

run = swanlab.init(project="histogram-demo")

samples = [0.0, 0.5, 1.0, 2.0, 3.0]
counts, bin_edges = np.histogram(samples, bins=[0.0, 1.0, 3.0])
hist = swanlab.Histogram(np_histogram=(counts, bin_edges))

run.log({"weights": hist}, step=0)
run.finish()
bin_edges 长度需等于 len(counts) + 1(桶数同样限 1–512),counts 需为非负整数,不支持概率密度或带小数的加权计数。
记录 PyTorch Tensor
支持直接传入 PyTorch Tensor(内部自动执行 detach().cpu(),支持 GPU Tensor、带梯度的 Tensor 及 bfloat16)。多维参数需先通过 .flatten() 展平为一维:
python
import torch
import swanlab

run = swanlab.init(project="histogram-demo")

model = torch.nn.Sequential(torch.nn.Linear(8, 16), torch.nn.Linear(16, 4))
optimizer = torch.optim.SGD(model.parameters(), lr=0.1)

for step in range(10):
    loss = model(torch.randn(32, 8)).pow(2).mean()
    optimizer.zero_grad()
    loss.backward()

    histograms = {}
    for name, param in model.named_parameters():
        histograms[f"params/{name}"] = swanlab.Histogram(param.detach().flatten())
        if param.grad is not None:
            histograms[f"grads/{name}"] = swanlab.Histogram(param.grad.detach().flatten())
    run.log(histograms, step=step)

    optimizer.step()

run.finish()
属性
构造后的 Histogram 实例包含以下属性:
| 属性 | 类型 | 说明 |
|---|---|---|
values | list[int] | 各桶的样本计数,长度为 N。 |
bins | list[float] | 桶边界列表,长度为 N+1。 |
is_valid | bool | 输入是否通过类型与维度校验;为 False 时在 log 时会自动跳过。 |
记录时只保存分桶后的 values 和 bins,无法还原原始样本。已上传的直方图可通过 Open API 读取。
注意事项
- 单个指标每次只能记录一个
Histogram,不支持像Image一样传入列表(传入列表会报错并丢弃)。如需同时记录多个分布,请使用不同的指标名。 - 同一指标在同一个
step只保留首次记录,后续重复记录会被跳过;指标类型在首次 log 时固定,不能将标量与直方图混用同一个指标名。 - 直方图图表的 X 轴固定为
step,define_metric(x_axis=...)对直方图不生效,仅section_name和hidden生效。 - 数值或长度不符合要求(如桶数超出
1–512、桶边界递减、未传sequence和np_histogram等)会抛出ValueError;输入类型或维度不合法(如未展平的多维数组、非数值对象)不会抛出异常中断训练,实例会被标记为is_valid=False,在log时自动跳过并记录到debug/debug.log。