

记录直方图
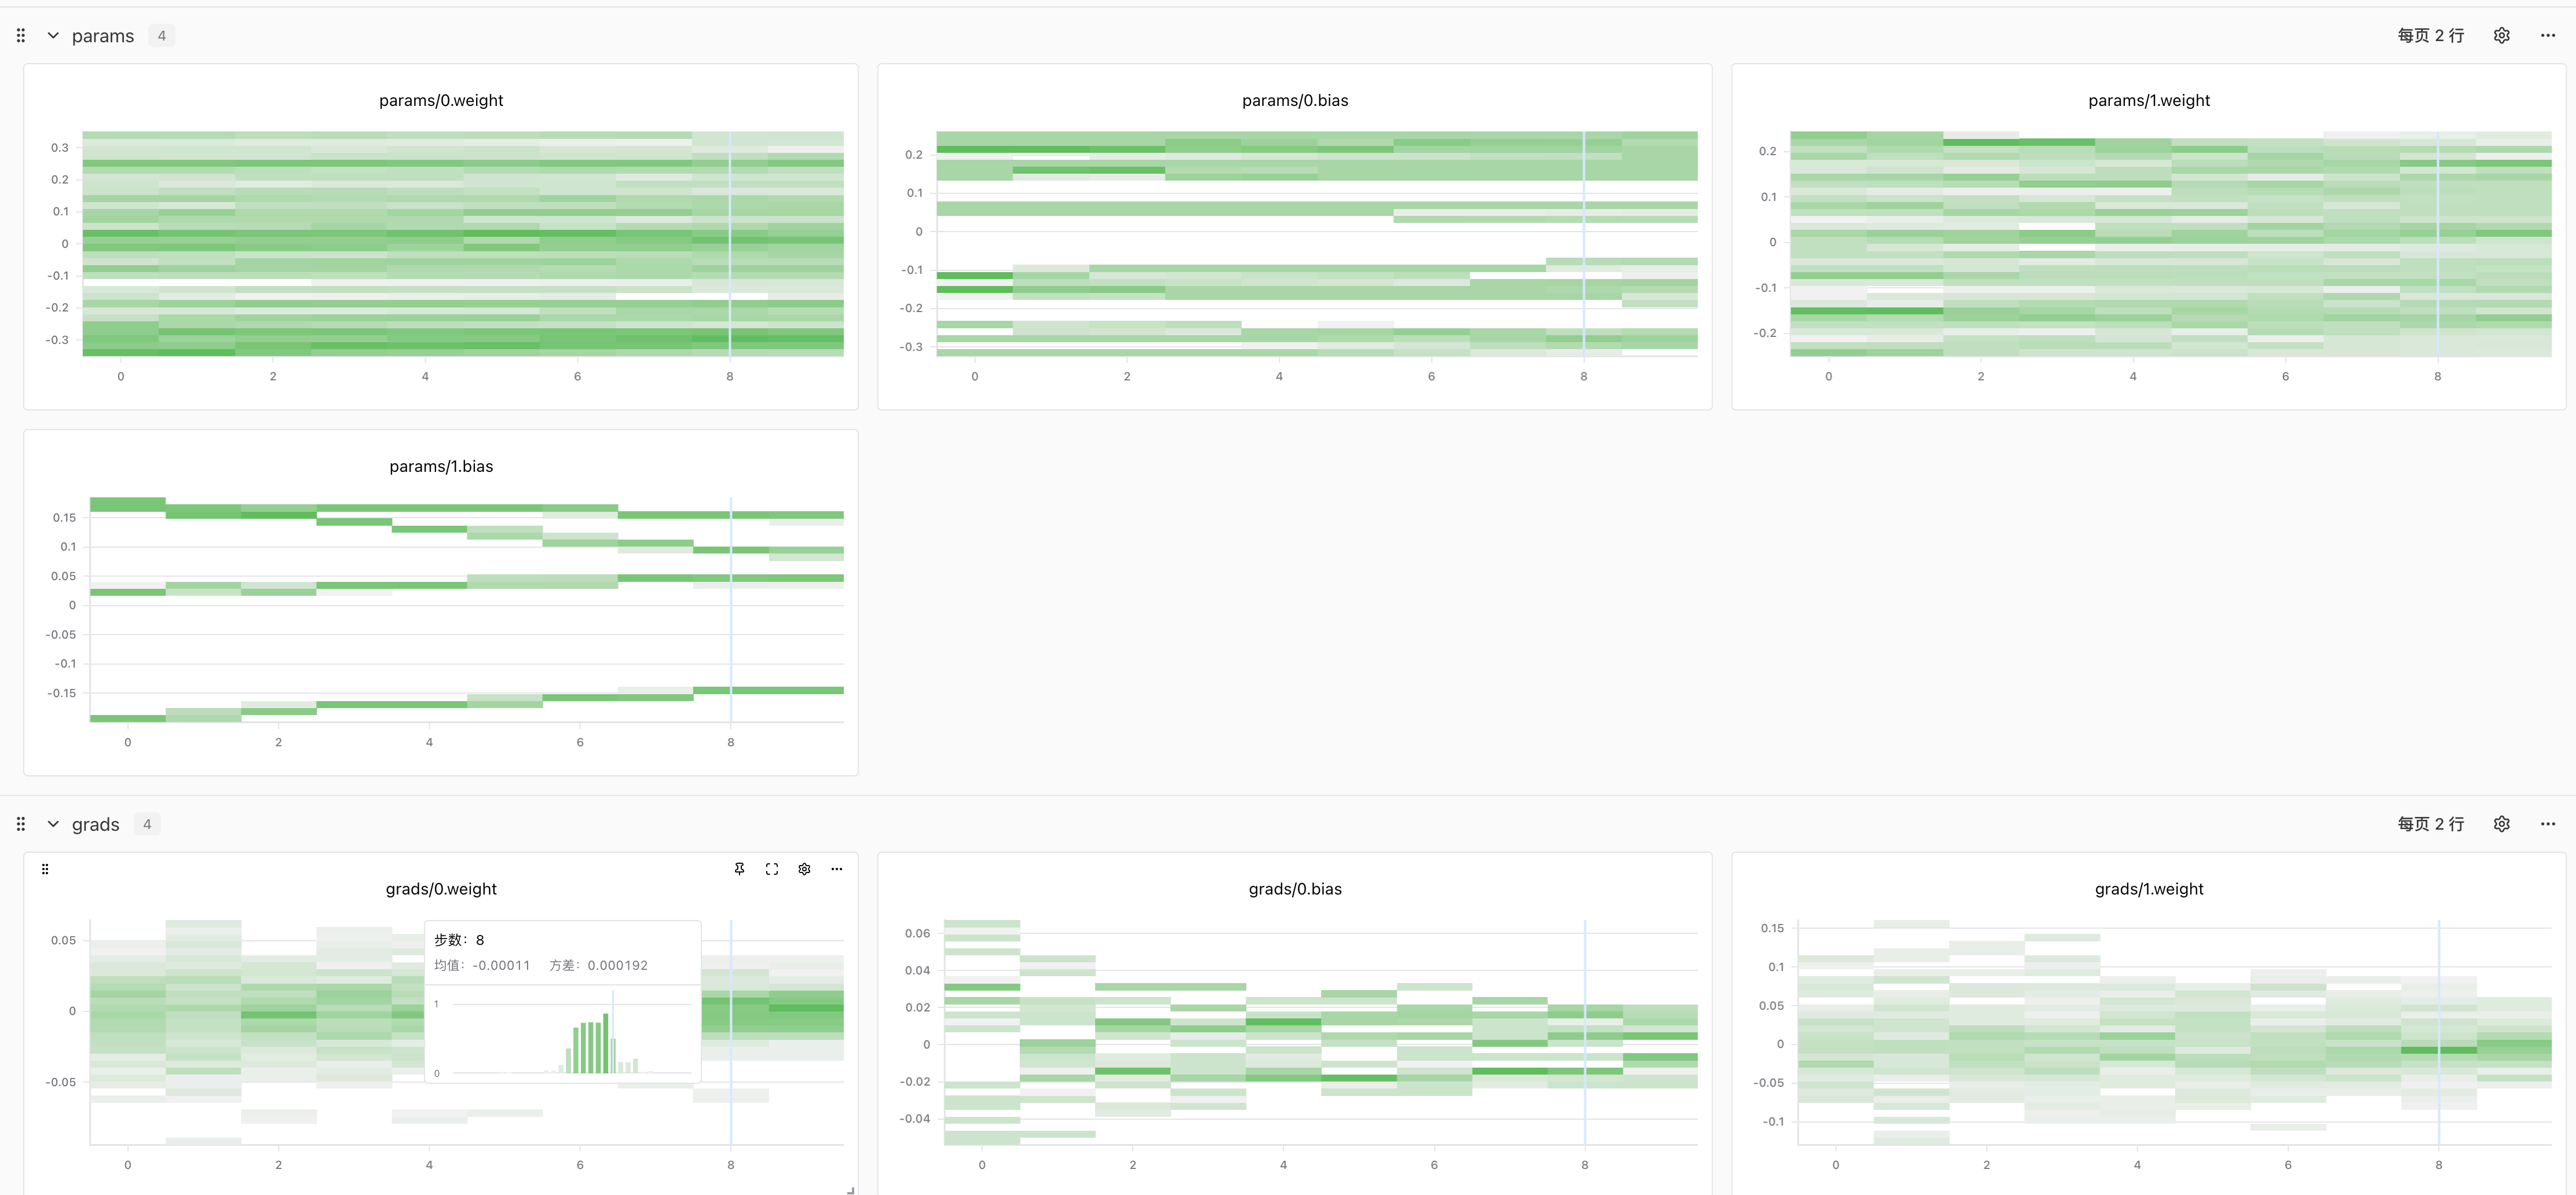
在模型训练过程中,除了标量指标(如 loss、acc)外,我们常常还需要观察模型权重、梯度、激活值随训练步数(step)的分布演化。SwanLab 提供 swanlab.Histogram 来记录每个 step 的一维数值分布快照。
1. 基本用法
将一维数值序列(如 list、NumPy 数组、PyTorch Tensor)传入 swanlab.Histogram,再通过 swanlab.log() 记录即可。默认会将当前样本按最小/最大值划分为 64 个等宽分桶(可通过 bins 指定 1–512 之间的桶数):
python
import numpy as np
import swanlab

run = swanlab.init(project="histogram-demo")

rng = np.random.default_rng(42)
for step in range(20):
    samples = rng.normal(loc=step * 0.1, scale=1.0, size=1000)
    run.log({"weights": swanlab.Histogram(samples, bins=64)}, step=step)

run.finish()
2. 跟踪 PyTorch 模型权重与梯度
swanlab.Histogram 原生支持 PyTorch Tensor(内部自动完成 detach().cpu(),支持 GPU Tensor 与 bfloat16)。对于多维参数,只需先通过 .flatten() 展平为一维:
python
import torch
import swanlab

run = swanlab.init(project="histogram-demo")

model = torch.nn.Sequential(torch.nn.Linear(8, 16), torch.nn.Linear(16, 4))
optimizer = torch.optim.SGD(model.parameters(), lr=0.1)

for step in range(10):
    loss = model(torch.randn(32, 8)).pow(2).mean()
    optimizer.zero_grad()
    loss.backward()

    histograms = {}
    for name, param in model.named_parameters():
        histograms[f"params/{name}"] = swanlab.Histogram(param.detach().flatten())
        if param.grad is not None:
            histograms[f"grads/{name}"] = swanlab.Histogram(param.grad.detach().flatten())
    run.log(histograms, step=step)

    optimizer.step()

run.finish()
3. 自定义分桶与复用 numpy.histogram
- 固定或非等宽分桶边界:向
bins直接传入递增的边界序列(N个桶对应N+1个边界值),适合跨 step 固定相同的分桶区间:
python
hist = swanlab.Histogram([0.0, 0.5, 1.0, 2.0, 3.0], bins=[0.0, 1.0, 3.0])
swanlab.log({"custom_bins": hist})- 直接传入预分桶结果:如果已经在外部调用了
numpy.histogram(),可通过np_histogram直接传入(counts, bin_edges),避免重复计算:
python
import numpy as np

counts, bin_edges = np.histogram(samples, bins=32)
swanlab.log({"pre_binned": swanlab.Histogram(np_histogram=(counts, bin_edges))})
4. 注意事项
- 单 key 单实例:直方图不支持像
swanlab.Image一样传入列表(如[hist1, hist2]),如需同时记录多个层的分布,请使用不同的 key(如params/layer1、params/layer2)。 - 横轴固定为
step:直方图图表的 X 轴固定为step,swanlab.define_metric(x_axis=...)对直方图不生效(但支持section_name分组与hidden隐藏)。 - 更多细节:完整参数说明与 OpenAPI 读取方式请参阅 Histogram API 文档 与 开放接口文档。