

Log Histogram
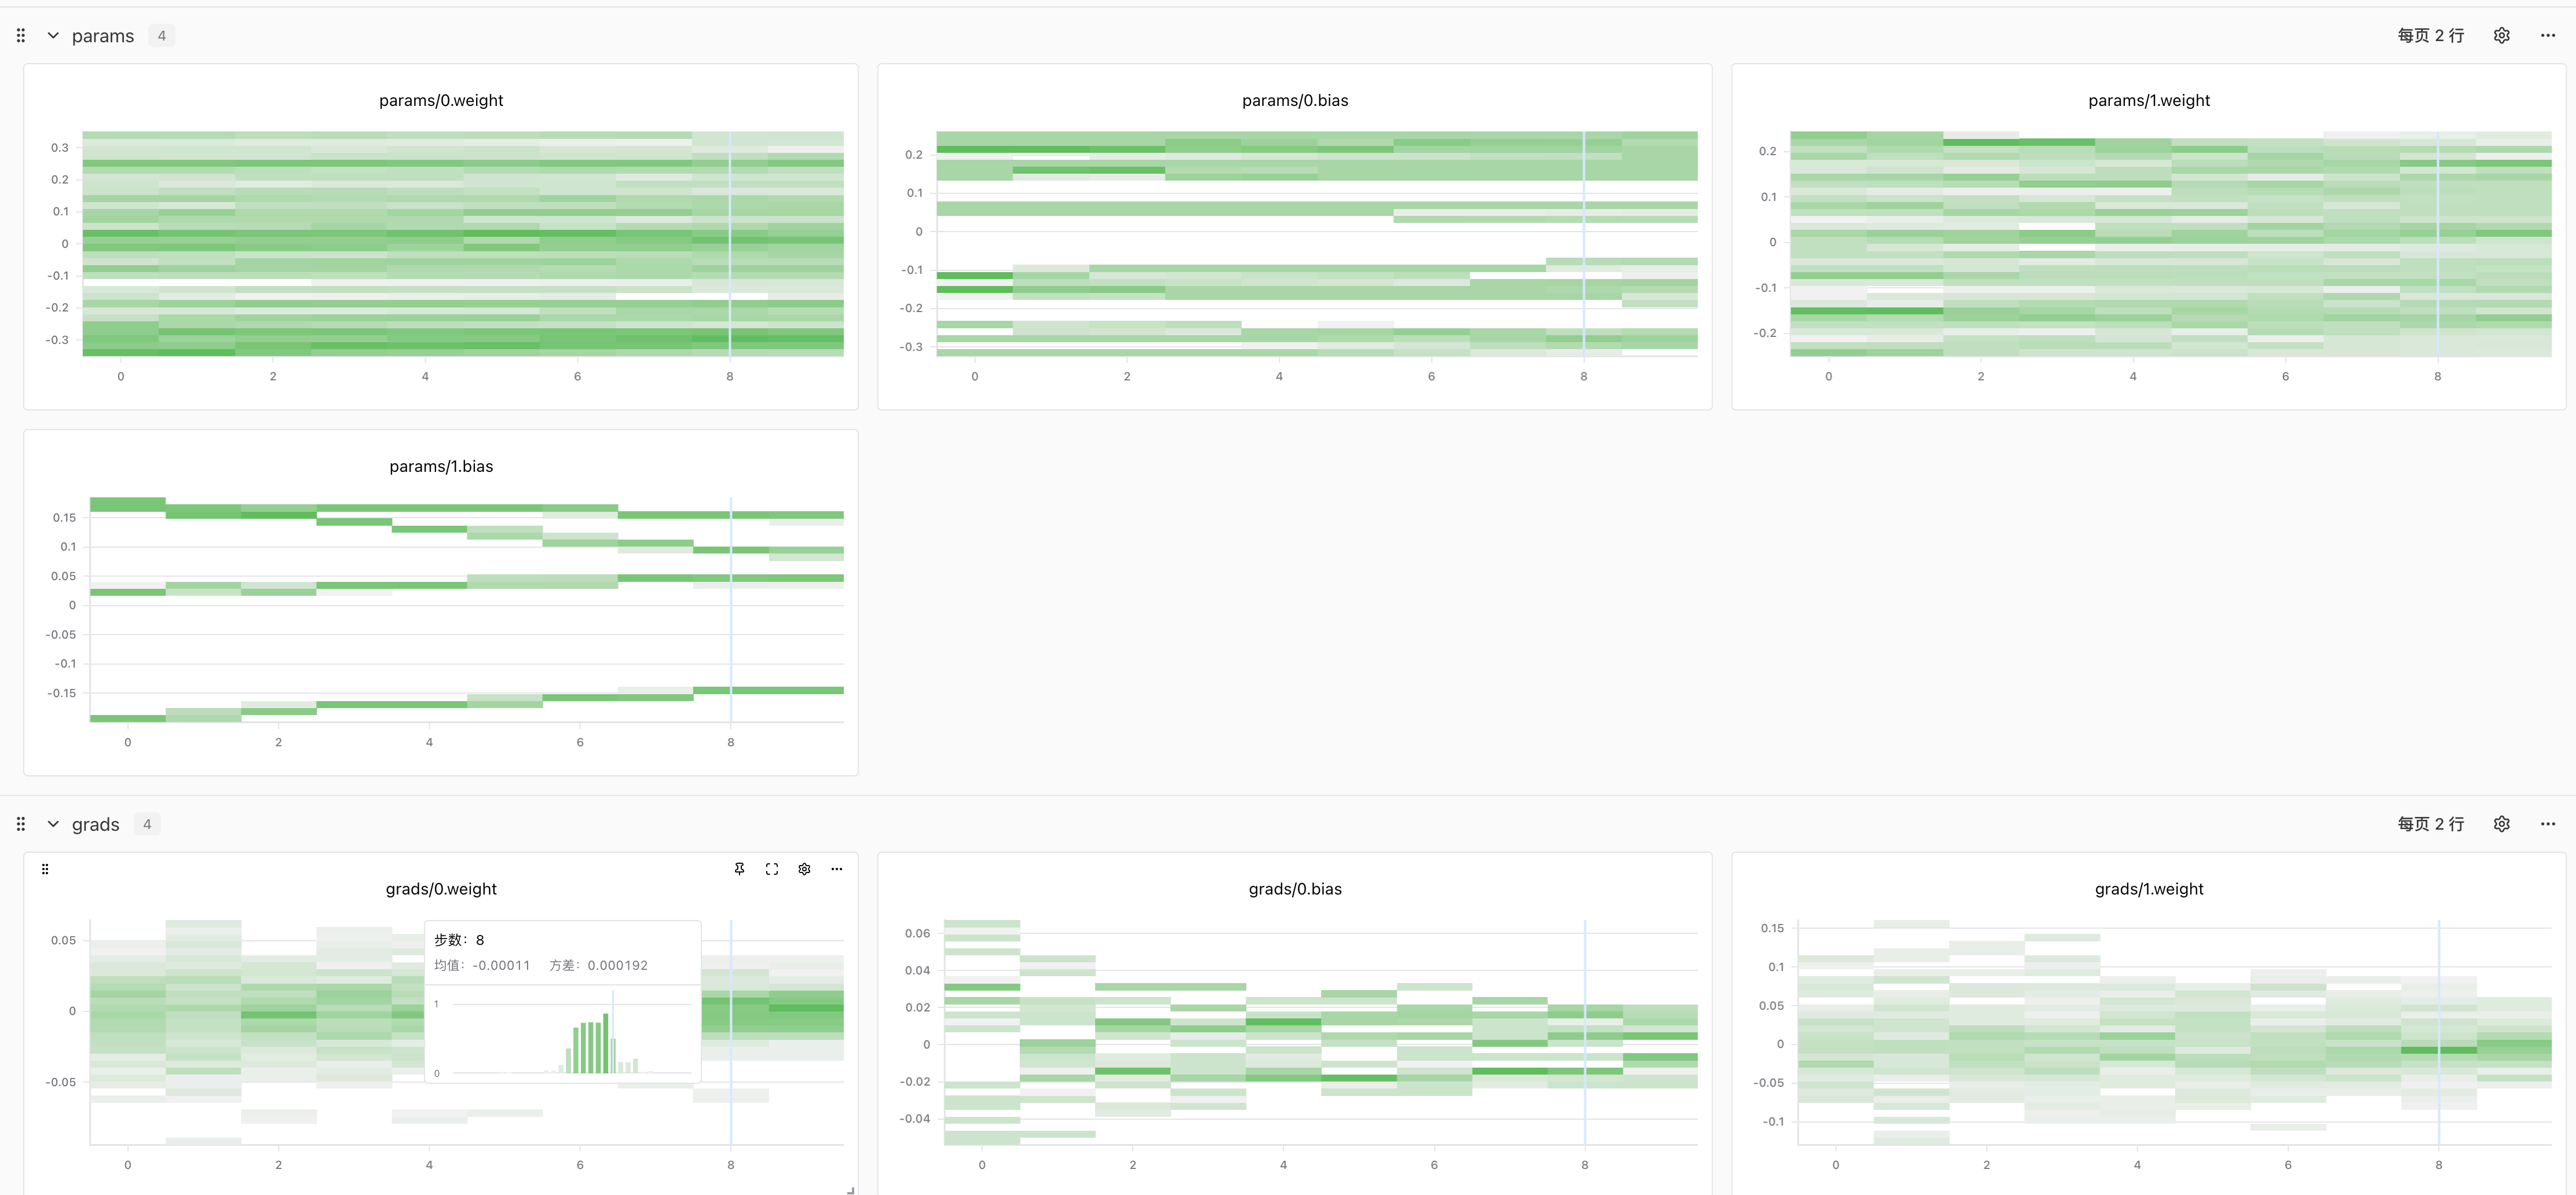
During AI model training, in addition to scalar metrics (such as loss and acc), it is often helpful to observe how the distributions of model weights, gradients, and activations evolve across training steps. SwanLab provides swanlab.Histogram to record 1D distribution snapshots at each step.
1. Basic Usage
Pass a 1D numeric sequence (such as a list, NumPy array, or PyTorch Tensor) to swanlab.Histogram and log it with swanlab.log(). By default, samples are split into 64 equal-width bins over their min/max range (you can set bins to any integer from 1 to 512):
import numpy as np
import swanlab

run = swanlab.init(project="histogram-demo")

rng = np.random.default_rng(42)
for step in range(20):
    samples = rng.normal(loc=step * 0.1, scale=1.0, size=1000)
    run.log({"weights": swanlab.Histogram(samples, bins=64)}, step=step)

run.finish()
2. Track PyTorch Model Weights and Gradients
swanlab.Histogram natively supports PyTorch Tensors (detach().cpu() is called automatically, supporting GPU tensors and bfloat16). For multidimensional parameters, flatten them to 1D with .flatten() first:
import torch
import swanlab

run = swanlab.init(project="histogram-demo")

model = torch.nn.Sequential(torch.nn.Linear(8, 16), torch.nn.Linear(16, 4))
optimizer = torch.optim.SGD(model.parameters(), lr=0.1)

for step in range(10):
    loss = model(torch.randn(32, 8)).pow(2).mean()
    optimizer.zero_grad()
    loss.backward()

    histograms = {}
    for name, param in model.named_parameters():
        histograms[f"params/{name}"] = swanlab.Histogram(param.detach().flatten())
        if param.grad is not None:
            histograms[f"grads/{name}"] = swanlab.Histogram(param.grad.detach().flatten())
    run.log(histograms, step=step)

    optimizer.step()

run.finish()
3. Custom Bin Edges and numpy.histogram Reuse
- Fixed or unequal-width bin edges: pass a non-decreasing sequence of edge values to
bins(Nbins requireN+1edges), which is useful when you want fixed bin intervals across steps:
hist = swanlab.Histogram([0.0, 0.5, 1.0, 2.0, 3.0], bins=[0.0, 1.0, 3.0])
swanlab.log({"custom_bins": hist})- Pre-binned results: if you have already computed
(counts, bin_edges)vianumpy.histogram(), pass it directly throughnp_histogramto avoid recomputing:
import numpy as np

counts, bin_edges = np.histogram(samples, bins=32)
swanlab.log({"pre_binned": swanlab.Histogram(np_histogram=(counts, bin_edges))})
4. Notes
- One
Histogramper key: unlikeswanlab.Image,Histogramdoes not accept a list of instances under a single key. Use separate keys (e.g.params/layer1,params/layer2) to track multiple distributions. - X axis is fixed to
step: histogram charts always usestepas the horizontal axis;swanlab.define_metric(x_axis=...)does not apply to histograms (section_nameandhiddenare supported). - More details: see the Histogram API Documentation and Open API Documentation for full parameter specifications and programmatic querying.